进行中AI
CodePilot AI
AI 工程能力提升平台
导入真实代码项目后形成成长闭环:代码扫描 → 12 维度 AI 工程审计 → 改进任务 → Git 代码评审 → 模拟面试 → 能力画像。评分由确定性引擎计算,LLM 只负责找问题。
角色 独立开发(产品设计 / 架构 / 后端 / 前端 / 安全 / 测试 / 部署)
- Next.js 14(App Router)
- TypeScript
- Tailwind CSS
- shadcn/ui
- TanStack Query
- Zod
- React Hook Form
- Python 3.13
- 还有 18 项技术
概览
面向计算机专业学生、实习生与初级开发者的 AI 工程能力提升平台。导入真实代码项目后,平台形成完整成长闭环:代码导入与扫描 → 12 维度 AI 工程审计 → 改进任务闭环 → Git 代码评审 → 模拟面试 → 能力画像与训练计划。
后端严格分层(API / Service / Repository / Model / Core),长任务走 Job 表 + 线程 Worker,前端为 Next.js 14 的完整工作台,并用 Docker Compose 一键部署。
问题
学生和初级开发者写过不少代码,但缺少「工程视角」的反馈:不清楚自己的项目在架构、安全、测试、DevOps 上处于什么水平,也不知道下一步该练什么。
通用 AI 问答给出的评价不可复现、落不到具体代码行,面试准备也缺少基于真实项目的追问。
平台自身同样面临典型工程难题:LLM 输出不可信、长任务耗时、多用户数据隔离与安全边界。
目标
把「代码能力提升」做成可执行闭环,而不是一次性评分:发现问题 → 生成任务 → 改代码 → AI 评审 → 能力画像发生变化。
评分必须可审计:总分由确定性评分引擎计算,LLM 只作为「找问题」的结构化抽取器。
工程可交付:分层后端、异步长任务、测试与 CI、Docker 一键部署、安全加固、真实 LLM 链路验证。
方案
审计结果拆成两层:LLM 只输出结构化 Finding(问题 + 位置 + 依据),总分由评分引擎按维度权重确定性计算,避免同一份代码多次审计分数漂移。
导入、审计、任务生成、代码评审这些耗时环节统一走 Job 表 + 线程 Worker,配合 request_id / job_id 双追踪,前端轮询状态,失败可查。
能力画像不靠模型打分,而是由审计、任务、Review、面试产生的真实记录汇聚而成,因此「改代码 → 完成任务 → 面试」之后分数变化可复现。
架构
前端 Next.js(Dashboard / Projects / Tasks / Git / Review / Interview / Skills / Learning)→ HTTP/JSON(/api/v1)→ FastAPI 后端严格分层:API 层(路由 / 鉴权 / 限流 / 参数校验)、Service 层(auth / audit / task / interview / skill / review / demo)、Repository 层(越权统一返回 404)→ Model 层(SQLAlchemy ORM,16 张表);Core 层包含配置、日志、LLM Provider、Prompt 边界、评分引擎、Git Service 与代码扫描器;线程 Worker 处理 import / analyze / generate_tasks / review_task;数据层为 PostgreSQL 16 + Redis 7 + 代码快照存储。
评分由确定性引擎计算,LLM 只输出 Finding
- 背景
- 让 LLM 直接给总分时,同一份代码多次审计分数会漂移,结果不可复现也无法解释。
- 选择
- 12 维度总分由确定性评分引擎加权计算,LLM 只产出结构化 Finding
- 原因
- 规则可审计、结果可复现,也不依赖模型自报分数。
- 考虑过的方案
- 让 LLM 直接输出总分
- LLM 只输出结构化问题,总分由代码按维度权重计算
- 代价
- 需要自己维护评分引擎与维度权重,而不是直接采用模型判断。
长任务用 Job 表 + 线程 Worker,而不是同步执行
- 背景
- 代码导入与 AI 审计耗时较长,放在请求里同步执行会阻塞接口且失败难以追踪。
- 选择
- 数据库 Job 表 + 线程 Worker + request_id / job_id 双追踪,前端轮询
- 原因
- 请求快速返回,任务状态落库可查,失败有记录。
- 代价
- 需要自己处理任务状态与并发,而不是直接在请求内完成。
统一 LLM Provider 抽象(DeepSeek / OpenAI / mock)
- 背景
- 测试与演示不应该消耗真实模型调用,但真实链路又必须被验证。
- 选择
- 三种 Provider 实现同一接口,mock 走同一套代码路径
- 原因
- 测试与演示零成本,真实链路与 mock 共用同一实现,避免「测试通过但真实路径没跑过」。
把用户代码当不可信输入
- 背景
- 平台会读取并分析用户上传的代码与仓库内容,这些内容可能包含改写系统指令的文本。
- 选择
- Prompt 注入边界:用户代码不能改写系统 Prompt 与工具权限,并补测试覆盖
- 原因
- 模型输入中混入不可信内容时,必须显式划定边界而不是依赖模型自觉。
技术栈
前端
- Next.js 14(App Router)
- TypeScript
- Tailwind CSS
- shadcn/ui
- TanStack Query
- Zod
- React Hook Form
后端
- Python 3.13
- FastAPI
- SQLAlchemy 2.0
- Pydantic v2
- Alembic
数据库
- PostgreSQL 16
- Redis 7
- SQLite(本地 / CI 降级)
- 16 张表
AI
- 统一 LLM Provider(DeepSeek / OpenAI / mock)
- 确定性评分引擎
- Prompt 注入边界
工具
- Git
- Tree-sitter(Python / JS / TS / Java / Go / SQL / HTML / CSS 八类语言)
测试
- pytest(186 用例)
- vitest(13 用例)
- typecheck / lint / build
DevOps 与基础设施
- Docker / Docker Compose
- GitHub Actions(lint + test + build)
基础设施
- Docker Compose(PostgreSQL + Redis + 前后端)一键部署
- GitHub Actions CI(lint + test + build)
- 本地无 Docker 时降级 SQLite
技术亮点
评分引擎确定性
12 维度总分由代码加权计算,LLM 只产出结构化 Finding,规则可审计、结果可复现,不信任 LLM 自报分数。
长任务异步化
数据库 Job 表 + 线程 Worker + request_id / job_id 双追踪,避免请求阻塞且失败可查。
AI Review 强制引用真实 diff
并用真实 Git 仓库验证「高危问题检出 → 修复 → 复检为 0」的闭环。
统一 LLM Provider 抽象
DeepSeek / OpenAI / mock 三种实现同一接口,测试与演示零成本,真实链路走同一套代码路径。
证据驱动的能力画像
分数来自审计 / 任务 / Review / 面试的真实记录,实测「改代码 → 完成任务 → 面试」后画像分数可复现变化。
安全边界
Prompt 注入边界、生产环境弱 JWT_SECRET 拒绝启动、Git 参数白名单防命令注入、ZIP 路径穿越 / 炸弹校验、登录注册限流。
难点与取舍
不信任 LLM 的自评分
- 问题
- 同一份代码多次审计分数不一致,结果不可复现,也无法解释分数从何而来。
- 做法
- 改为「LLM 只输出 Finding,总分由确定性评分引擎按维度权重计算」。
- 结果
- 评分可复现、可审计,维度得分能对应到具体问题。
长任务阻塞与状态可见性
- 问题
- 导入与审计耗时较长,同步执行会拖住接口,失败后也看不到卡在哪一步。
- 做法
- 导入 / 审计 / 任务生成走 Job 表 + 线程 Worker + 前端轮询。
- 结果
- 失败落库、状态可追踪。
Prompt 注入与不可信内容边界
- 问题
- 被分析的代码本身可能包含试图改写系统指令的文本。
- 做法
- 把用户代码与仓库内容标记为不可信,禁止其改变系统 Prompt 与工具权限,并补测试覆盖。
- 结果
- 不可信输入无法越过预设边界。
文件与命令安全
- 问题
- ZIP 上传与 Git 操作都可能被构造出越权或注入行为。
- 做法
- ZIP 路径穿越 / ZIP 炸弹 / 大小限制校验;Git 操作参数白名单(commit hash 仅允许十六进制)。
- 结果
- 上传与 Git 操作被限制在安全范围内。
多租户数据隔离
- 问题
- 多用户共享同一套资源表,越权访问会泄露他人数据。
- 做法
- 所有资源按 owner 校验,越权统一返回 404。
- 结果
- 不通过错误码泄露资源是否存在。
环境兼容
- 问题
- 本机 PostgreSQL 受安全软件限制,无法在本地完整跑通全部回归。
- 做法
- PostgreSQL / SQLite 同构支持(本地与 CI 降级 SQLite),Alembic 迁移兼容方言差异。
- 结果
- 回归可在 SQLite 上完整执行,同时保留 PostgreSQL 部署路径。
权衡取舍
评分来源
选了 确定性评分引擎 + LLM 结构化 Finding,而不是 让 LLM 直接给出总分 —— 模型自评分数会漂移且无法解释,工程审计结论必须可复现。
代价:需要自己维护维度权重与评分规则。
任务执行方式
选了 Job 表 + 线程 Worker + 前端轮询,而不是 在请求内同步执行长任务 —— 接口需要快速返回,任务状态需要持久化与可追踪。
代价:需要自己承担任务状态管理,长任务仍在单进程内执行。
数据库兼容策略
选了 PostgreSQL / SQLite 同构支持并允许降级,而不是 只支持 PostgreSQL —— 本机环境受限,CI 与本地开发需要能完整跑回归。
代价:需要处理方言差异并维护迁移兼容性。
结果
测试:后端 pytest 186 用例、前端 vitest 13 用例通过、typecheck / lint / build 通过;CI 覆盖 lint + test + build。
端到端实测(mock provider,走真实代码路径):注册 → 导入并扫描 132 个文件 → AI 审计 65.5 分(12 维度)→ 12 条 Finding → 12 个改进任务 → 完成 1 个任务 + AI Review(pass) → 模拟面试 90.8 分 → 能力画像 64.6 分(证据链完整)。
真实 LLM 冒烟(DeepSeek):对 Demo 项目完成真实审计,评分 33.8、12 维度 19 条真实 Finding(例如「API 层直接包含业务逻辑和 SQL 查询」「空 except 吞异常」)。
真实 Git 仓库验证:引入硬编码密码 + SQL 字符串拼接 → Review 报出 2 个高危 → 修复后复检 0 问题。
交付:Docker Compose(PostgreSQL + Redis + 前后端)一键部署、Demo 模式零上传体验、部署与验收文档齐备。
线上部署:https://codepilot.myiskg.com/ (腾讯云 Docker Compose 一键部署,支持 Demo 模式零上传体验;线上需注册账号后使用,登录页与注册页均已实测截图)。2026-09-24 起启用 HTTPS,同时把前端写死的 http API 基址改为同源相对路径,避免浏览器按混合内容拦截。
诚实边界(面试如实说明):本机 PostgreSQL 受安全软件限制,全量回归在 SQLite 上完成;限流为进程内实现,多实例需换 Redis 集中限流;演示视频待补。
收获
不能让模型给自己打分:把「找问题」和「算分数」拆开后,结果才可复现,也更敢用在需要解释的场景里。
不可信输入要显式划定边界:用户代码进入 Prompt 时,权限与指令边界必须写进系统约束并用测试守住。
环境限制要如实记录:把「回归在 SQLite 上完成」「限流是进程内实现」写进结果,比含糊带过更可信。
截图
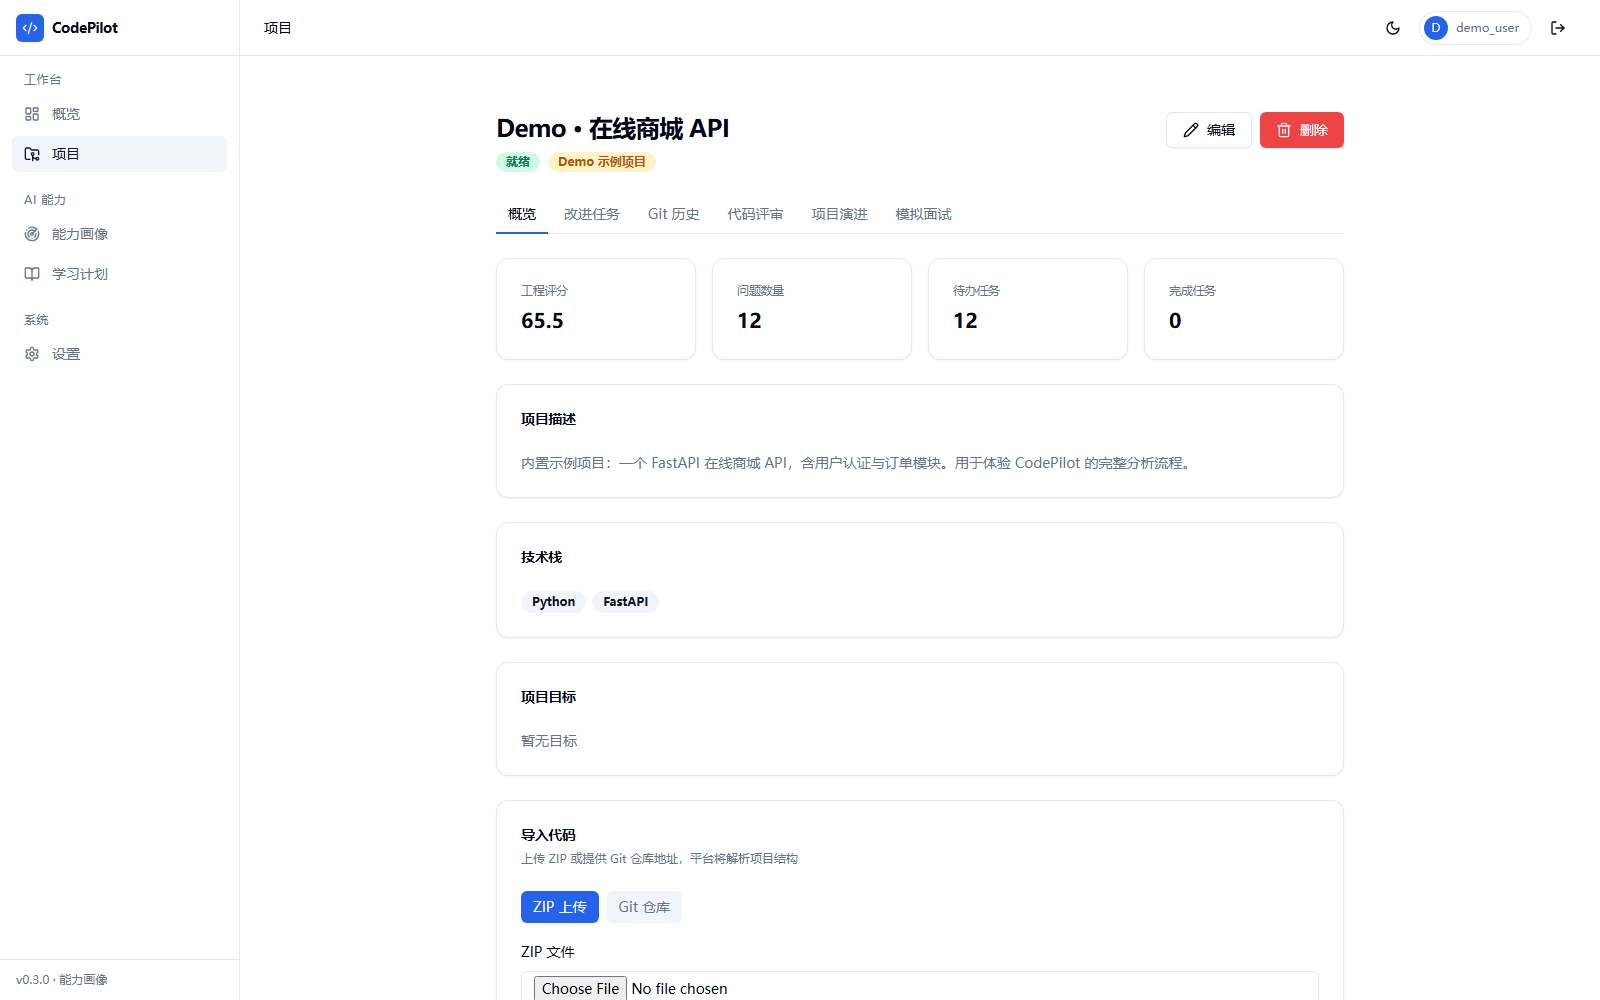
项目审计总览:12 维度评分与审计历史 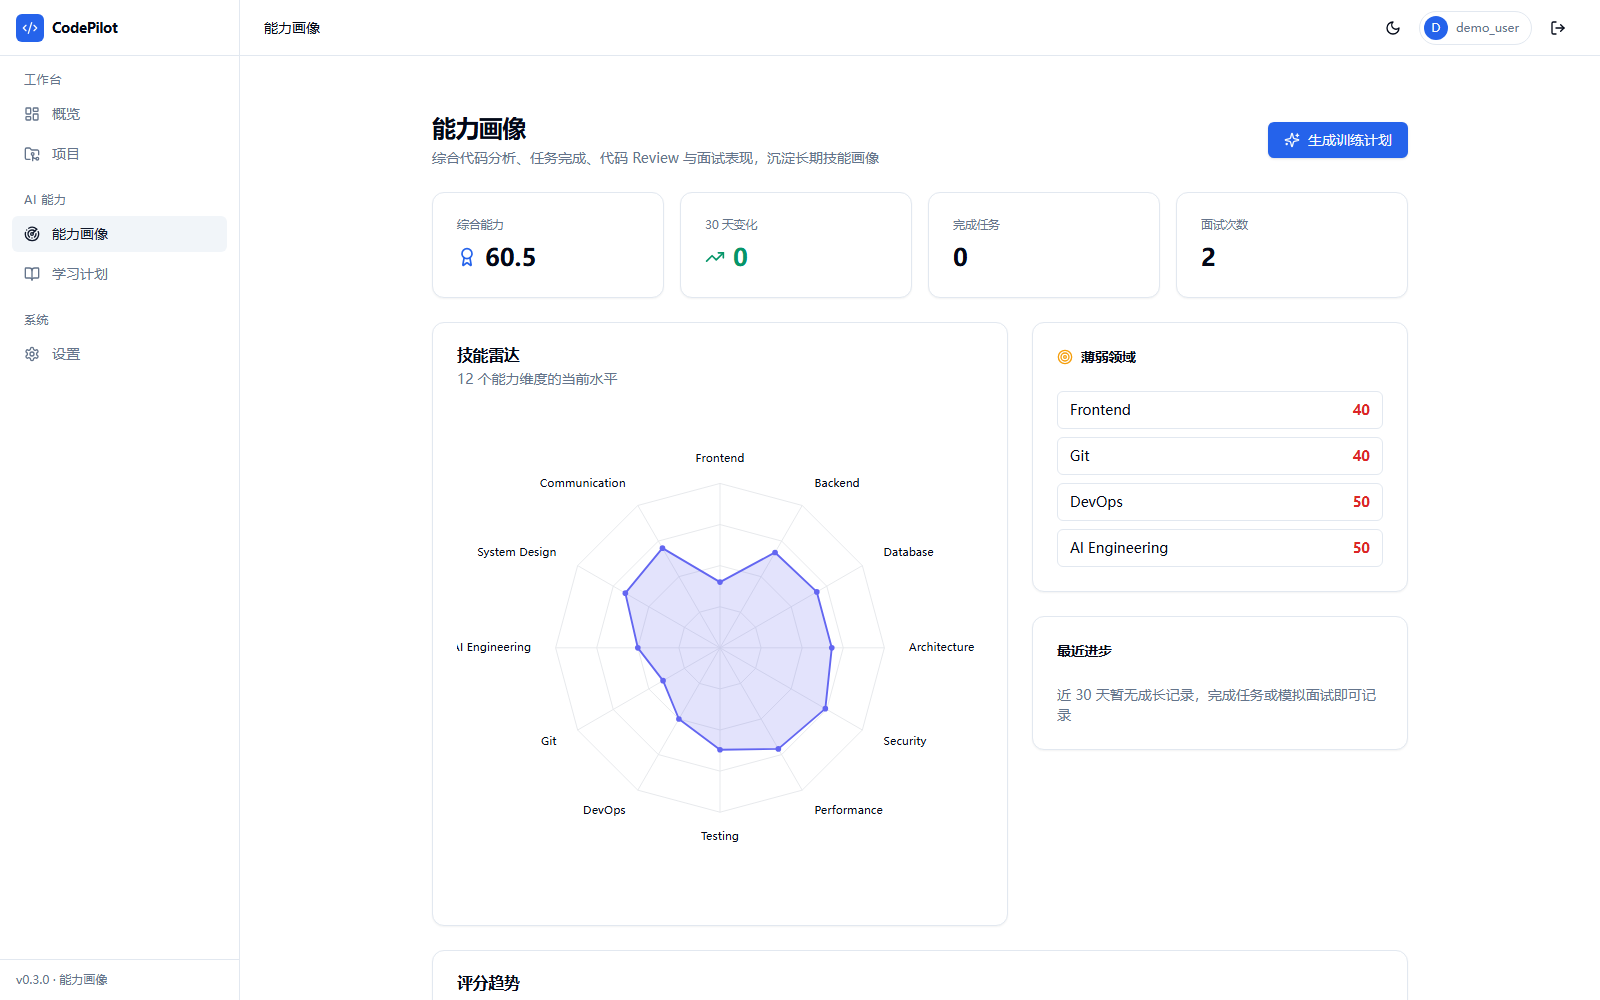
能力画像:12 维雷达图与维度详情 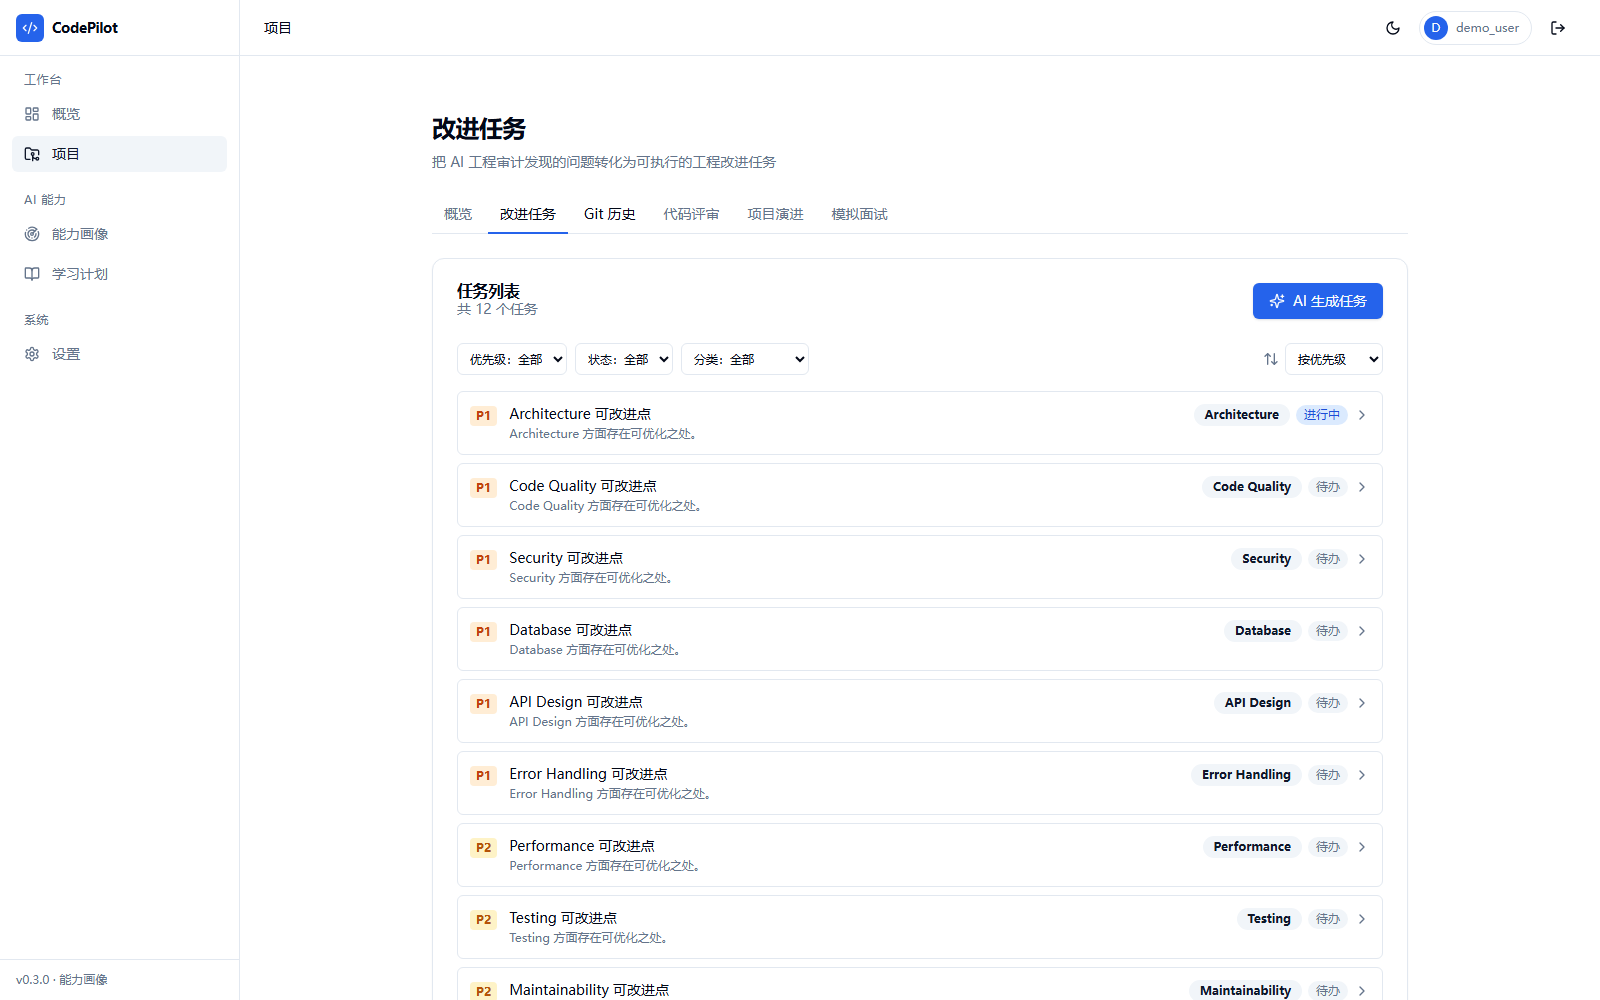
改进任务闭环:Finding 转任务与状态跟踪 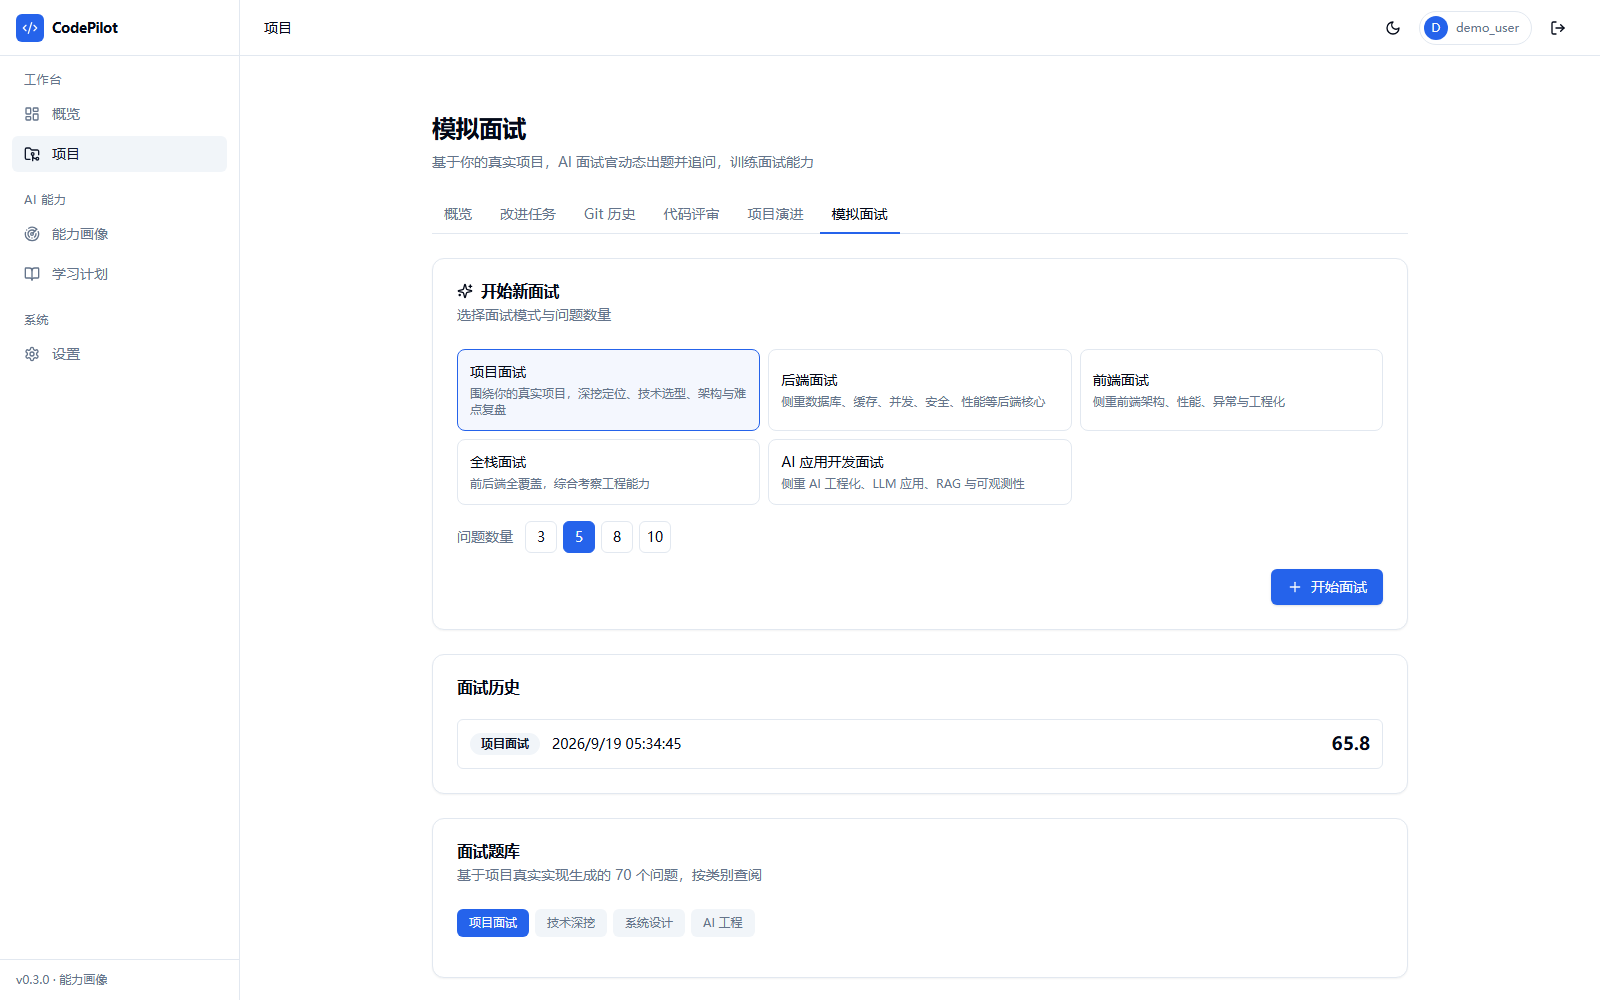
模拟面试:基于项目上下文的追问与报告 
线上实测:登录页 
线上实测:注册页(线上需注册账号后使用)