ActiveAI
DocWise
带评测体系的 RAG + Agent 知识库问答平台
上传文档即可问答的 RAG 平台:标题感知分块 + BM25/向量混合检索 + Rerank + SSE 流式回答,自带 52 题评测体系与 Agent 工具调用。
Role 独立开发(需求 / 架构 / 后端 / 前端 / 评测 / 部署)
- Python 3.11+
- FastAPI(异步)
- httpx
- SSE 流式响应
- OpenAI 兼容接口(默认 DeepSeek)
- bge-m3 向量化
- 自研 BM25 + 向量余弦混合检索
- Rerank(OverlapRerank / bge-reranker API)
- 16 more technologies
Overview
上传任意文档(txt / md / pdf / docx),系统自动完成「解析 → 标题感知分块 → 向量化 → BM25 + 向量混合检索 → Rerank 精排 → SSE 流式回答」,回答带可点击的引用出处。
支持追问改写、知识库外问题的 strict / chat 双模式兜底,以及 Agent 工具调用(计算器 / 维基百科搜索)。项目自带 52 条测试集 + 20 篇语料的评测体系,用真实数据驱动每一次优化。
Problem
私有文档(课程笔记、面试笔记、项目手册)分散,通用大模型无法直接基于它们作答,直接提问既容易幻觉又无法溯源。
常见的「调个 API」问答 Demo 缺三件东西:回答不可溯源、效果没有量化评测、工程不可测试与部署。
RAG 链路长(分块 → 嵌入 → 检索 → 重排 → 生成),任何一环出问题肉眼都发现不了;没有评测,「优化」就只是玄学。
Goal
做一个可对话、可溯源、能执行任务的文档助手,而不只是会聊天的壳。
效果必须可量化:自建测试集与指标(检索命中率 / 忠实度 / 相关性),每次优化都有前后对比数据。
工程可交付:单元测试、静态检查、CI、Docker 部署、可演示;无 API Key 时也能离线跑通全链路。
Solution
后端提供文档服务与聊天服务两条链路:文档服务负责上传、解析与入库;聊天服务负责检索与生成,两者共用同一套存储抽象层。
检索环节没有直接依赖现成框架,而是自己实现 BM25 与向量的加权融合并接一层 Rerank,使每一层的原理与权重都可以解释和调整。
另建一套离线评测服务:52 条测试集 × 4 档检索配置 + LLM-as-Judge 生成质量打分,报告落盘到 docs/eval/,让每次改动都有可比数据。
Architecture
浏览器(React + Vite,通过 SSE 接收流式 token)→ FastAPI 应用层(路由 / 鉴权 / 令牌桶限流 / JSON 结构化日志)→ 文档服务(上传 → 解析 → 标题感知分块 800 字符 / 100 重叠 → Embedding → 入库)、聊天服务(查询改写 → 混合检索 → Rerank → 组装 Prompt → 流式生成 → 引用溯源)、Agent 执行器(Function Calling 循环,工具注册表 + max_turns 防死循环)与存储抽象层(向量存储接口:内存实现,可换 FAISS / pgvector / Milvus);离线评测服务独立于请求链路运行。
自研 BM25 + 向量混合检索,而不是直接引入检索框架
- Context
- 纯向量检索在跨主题问题上会漏检:top-1 严格模式下「Transformer 为什么是大模型的基石」被语义相近的「大模型笔记」带偏。
- Chosen
- 自己实现轻量 BM25 + 向量混合检索,并加一层 Rerank
- Why
- BM25 的精确关键词命中能补上纯向量的跨主题漏检,且自己实现后每一层的原理与权重都能讲清楚。
- Alternatives considered
- 继续用纯向量检索并调参
- 引入现成的检索框架
- 自己实现 BM25 与向量的加权融合
- Trade-off
- 需要自己维护检索实现与调参,而不是依赖框架的默认行为。
向量存储接口先行,MVP 用内存实现
- Context
- 项目初期数据量很小,但检索层未来仍可能增长到需要专用向量库。
- Chosen
- 先用内存实现对接口编程,业务代码不感知具体实现
- Why
- 避免为一个 MVP 引入额外的基础设施,同时把演进路径保留下来。
- Alternatives considered
- 一开始就上 FAISS / pgvector / Milvus
- 先用内存实现并抽象出存储接口
- Trade-off
- 内存实现不适合大规模数据,演进到向量数据库时需要替换实现(业务层不变)。
用评测体系驱动优化,而不是凭感觉调参
- Context
- RAG 链路长,肉眼无法判断一次改动究竟让效果变好还是变差。
- Chosen
- 自建 52 条测试集与 20 篇语料,跑四档检索配置对比并用 LLM-as-Judge 打分,报告落盘可复现
- Why
- 有了固定测试集与指标,优化才有前后对比,问题也能被定位到具体环节。
- Trade-off
- 需要额外维护测试集、语料与评测脚本,并承担 Judge 本身的调用成本。
Tech stack
Backend
- Python 3.11+
- FastAPI(异步)
- httpx
- SSE 流式响应
AI
- OpenAI 兼容接口(默认 DeepSeek)
- bge-m3 向量化
- 自研 BM25 + 向量余弦混合检索
- Rerank(OverlapRerank / bge-reranker API)
- jieba 分词(可回退零依赖方案)
- 离线 hash embedding 兜底
Frontend
- React 18
- Vite
- TypeScript
- Markdown 渲染
- 引用高亮
Database
- 向量存储接口(内存实现)
- 预留 FAISS / pgvector / Milvus
Testing
- pytest(127 用例)
- vitest(19 用例)
- Ruff
- ESLint
DevOps & infrastructure
- GitHub Actions CI
- Docker Compose
- Nginx
Infrastructure
- Docker Compose(Nginx + FastAPI)
- GitHub Actions CI(lint + test + build)
- 离线可运行的评测脚本
Technical highlights
自研混合检索与 Rerank 全链路
不依赖现成检索框架,自己实现 BM25 + 向量加权融合与 Rerank,每一层的原理与权重都能解释和调整。
向量存储「接口先行」
MVP 用内存实现,业务代码不感知具体存储,演进到 FAISS / pgvector / Milvus 只需要替换实现。
评测驱动开发
52 条测试集 + 20 篇语料(85 块)、四档配置对比 + LLM-as-Judge 判分,报告可复现。
可插拔设计:无 Key 也能跑通全链路
Embedding(真实 API / 离线 hash)、分词(jieba / 零依赖)、Rerank(自研 / API)均可切换。
Agent 工具闭环
统一工具注册(name / description / schema / handler)+ 流式 tool_call 聚合 + max_turns 防死循环。
工程化交付
127 个后端用例(全离线)+ 19 个前端用例、Ruff 0 告警、CI、Docker + Nginx(SSE 关闭缓冲)。
Challenges & trade-offs
纯向量检索的跨主题漏检
- Problem
- top-1 严格模式下,「Transformer 为什么是大模型的基石」被语义相近的「大模型笔记」带偏。
- Impact
- 这类问题肉眼很难发现,只有靠评测集逐题对比才暴露出来。
- Approach
- 改用 BM25 精确关键词命中的混合检索修正。
- Outcome
- 检索命中率从 96.2% 提升到 98.1%。
评测自身的可信度问题
- Problem
- 忠实度一度只有 0.25,明显与人工观察不符。
- Impact
- 如果直接相信这个分数,会误判检索与生成质量,优化方向也会跑偏。
- Approach
- 定位到是引用预览被截断到 200 字符、污染了 Judge 的上下文;新增 citation_preview_len 参数(前端仍用 200,评测用 2000)。
- Outcome
- 忠实度恢复到 0.99。
幻觉控制
- Problem
- 知识库外的问题如果放任模型自由作答,会出现编造内容且无法溯源。
- Approach
- 用相关度阈值做 strict / chat 双模式分流,强制回答带引用;未命中时明确说明「知识库中没有相关内容」。
- Outcome
- 回答始终可溯源,不再硬编答案。
LLM 流式与工具调用
- Problem
- SSE 分片返回的 tool_call 需要聚合,工具结果还要回填后续答;上传 → 解析 → 入库链路同步执行会阻塞请求。
- Approach
- 实现分片 tool_call 聚合、工具结果回填 role=tool、max_turns 防死循环,并把上传 → 解析 → 入库链路异步化。
- Outcome
- 流式与工具调用可同时工作,上传不再阻塞其它请求。
零 Key 环境可验证
- Problem
- CI 与本地环境没有可用的模型 API Key,如果全链路依赖外部服务,测试就无法稳定运行。
- Approach
- 内置离线 hash embedding 与离线评测脚本,127 个后端用例全部离线可跑。
- Outcome
- CI 不依赖外部 API 也能验证全链路。
成本与滥用防护
- Problem
- 接口暴露后存在 Key 被刷爆的风险,重复查询也会浪费 embedding 调用。
- Approach
- 按 IP 令牌桶限流,并给检索结果加 TTL 缓存跳过重复 embedding。
- Outcome
- 降低延迟与调用成本,同时限制滥用。
Trade-offs
检索实现方式
Chose 自研轻量 BM25 + 向量混合检索 over 直接引入现成检索框架 — 跨主题漏检需要 BM25 的精确命中能力,自研后每一层权重都可解释、可调整。
Cost: 检索层由自己维护,需要自己承担调参与正确性验证。
向量存储方案
Chose 内存实现 + 存储接口抽象 over 一开始就引入 FAISS / pgvector / Milvus — MVP 阶段数据量小,不值得为它引入额外基础设施。
回答模式
Chose strict / chat 双模式按相关度阈值自动分流 over 只保留一种回答模式 — 严格模式防幻觉,但未命中时用户体验差;放开模式能兜底,但必须明确告知依据来源。
Results
检索命中率(top-1,52 题 / 20 篇语料 / 85 块,bge-m3 真实嵌入):纯向量 96.2% → 混合检索 98.1%。
生成质量(LLM-as-Judge,DeepSeek 判分,52 题):引用命中 100%、忠实度 0.99、相关性 0.95。
性能与成本(实测均值):单次问答约 1.9–2.3 s,约 ¥0.0034–0.004 / 次。
质量门禁:后端 pytest 127 用例全绿(全离线)、前端 vitest 19 用例通过、Ruff 0 告警、CI(lint + test + build)。
评测产出:抓到并修复「引用截断误判」(忠实度 0.25 → 0.99)与「Transformer 跨主题漏检」两个真实问题;同时如实记录 2 道所有配置都漏的题,主动暴露方案边界。
在线系统:https://docwise.myiskg.com/ (自 2026-09-24 起启用 HTTPS,证书由 Let's Encrypt 签发并自动续期)。
交付物:Docker Compose(Nginx + FastAPI)部署方案与部署指南、3 分钟演示脚本、24 问面试题库、投递前检查清单。
Learnings
评测链路本身也需要被验证:忠实度异常时,先怀疑评测口径(引用预览被截断污染了 Judge 上下文),再怀疑模型能力。
方案边界要主动暴露:把「所有配置都漏」的题目如实记录,比只展示成功案例更能说明方案的真实适用范围。
离线可运行是可验证性的前提:把 embedding、分词与 Rerank 都做成可插拔,CI 才能不依赖外部 API 稳定跑完整链路。
Screenshots
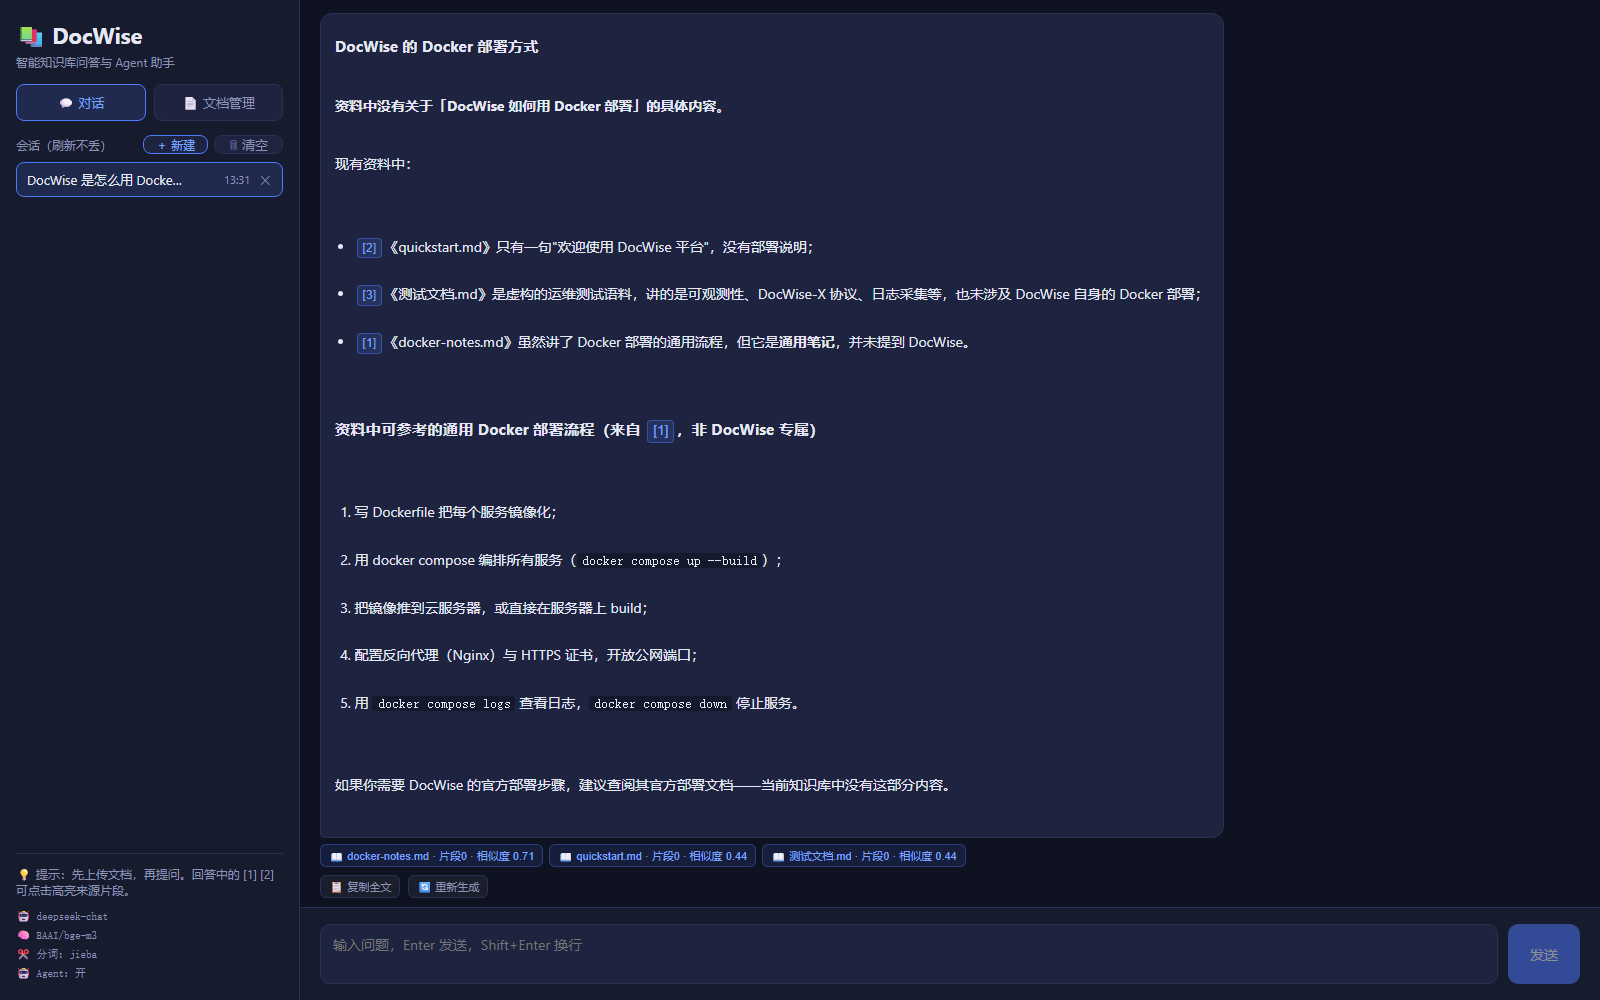
RAG 问答界面:流式回答与可点击引用 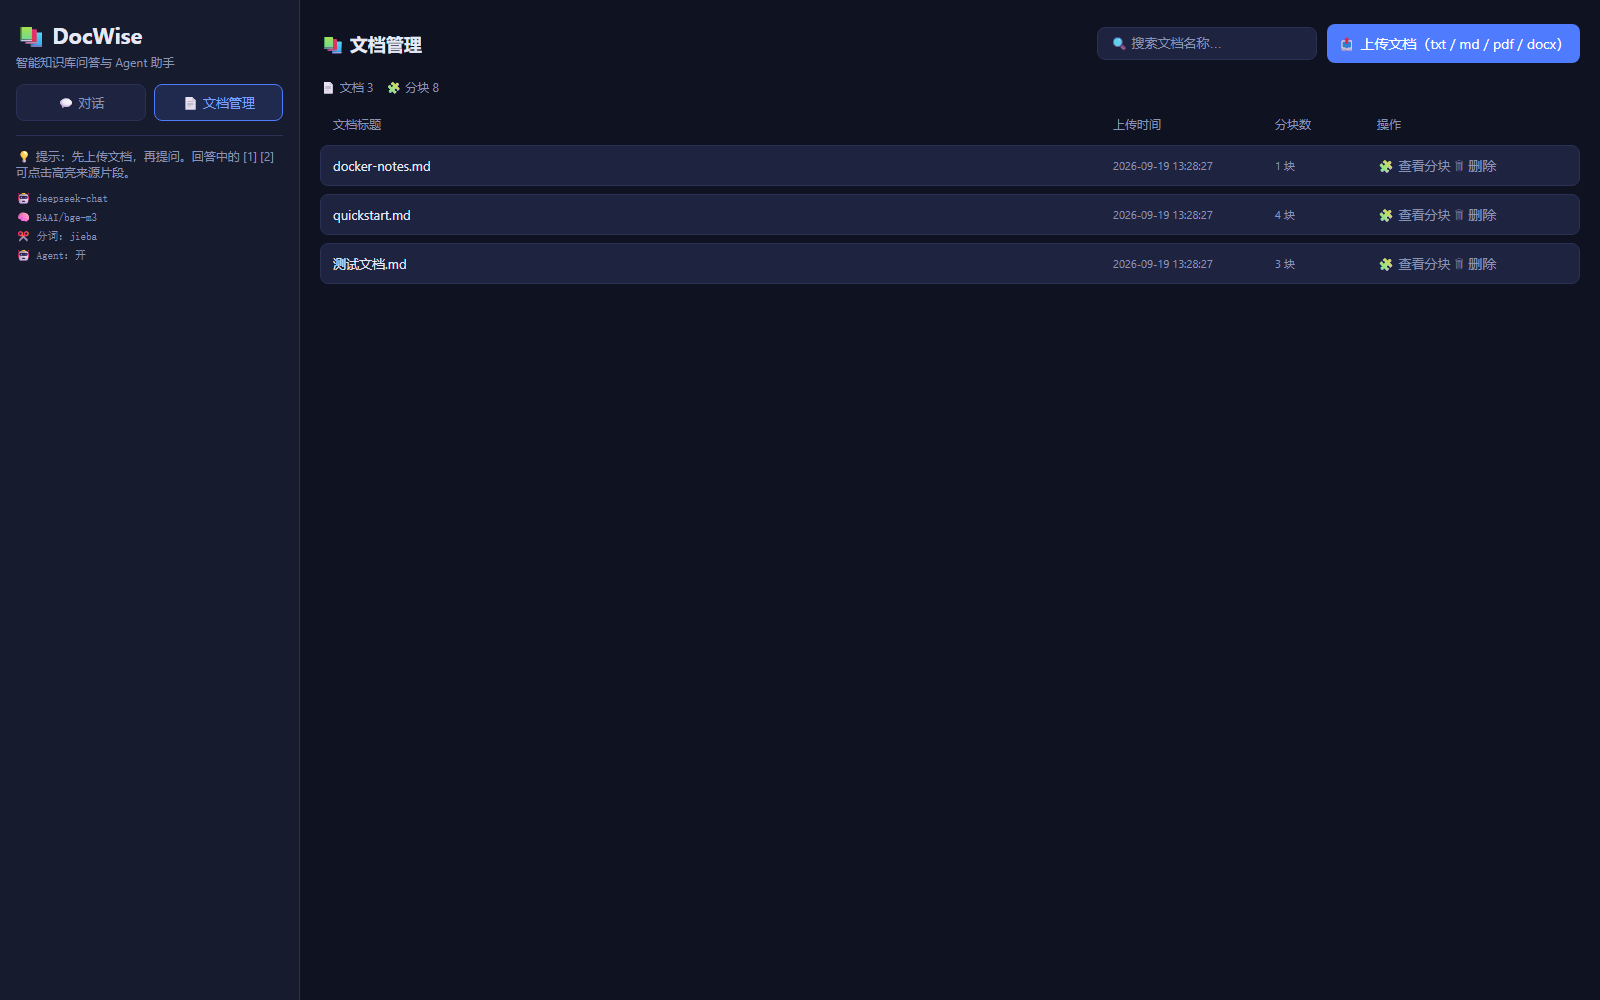
知识库文档管理:分块入库与检索