进行中AI
Intel Agent
智能行业情报分析 Agent —— 自动化情报采集分析与日报流水线
每天自动采集行业资讯,经关键词过滤、双重去重、LLM 结构化分析与 RAG 历史关联后,产出可视化看板、对话式问答与每日邮件日报;改一个配置即可切换行业。
角色 独立开发(选题 / 架构 / 后端流水线 / 看板 / 测试 / 部署)
- Python
- feedparser
- requests(超时重试 / 信源健康探测 / 熔断)
- run_daily.py 编排
- OpenAI 兼容 LLM(DeepSeek)结构化输出
- bge-m3 embedding
- numpy 余弦检索
- 周度趋势聚类
- 还有 10 项技术
概览
每天自动从 36氪 / IT之家 / 少数派采集电商与消费行业资讯,经过关键词过滤、双重去重、LLM 结构化分析(摘要 / 情感 / 标签 / 实体)、RAG 历史关联与周度趋势聚类,产出 Streamlit 可视化看板、对话式问答与每日 HTML 邮件日报。
负面高置信事件会实时推送到钉钉 / 企业微信 Webhook。所有信源与行业关键词都在配置里,改一个 config.yaml 即可切换到任意行业,零代码改动。
问题
运营、投研、竞品分析都需要持续跟踪行业资讯,人工每天搜集、去重、摘要在几十上百条信息量下不可持续。
同一事件被多家媒体重复报道,只按 URL 去重收敛不到「事件」粒度;而关键词匹配又抓不到语义相关的历史动态。
这类自动化系统依赖多(数据源、LLM、邮件、Webhook),任何一环挂掉都会导致「当天没有日报」。
目标
做一条端到端可自动运行的流水线:采集 → 清洗去重 → LLM 分析 → RAG 关联 → 看板 → 日报 / 告警。
工程上要「可降级、可验证、可算成本」:每个模块能 dry-run、无 Key 不崩、LLM 用量可核算。
技术选型匹配业务规模:小数据量不引入向量数据库等重基础设施,同时预留清晰的演进路径。
方案
用 RSS 而不是硬爬做数据源,把精力集中在 LLM 应用层;采集、分析、检索、事件聚合各自独立成模块,由 run_daily.py 统一编排。
去重分两层:URL 唯一约束做精确层,标题相似度做事件层,把去重粒度从「链接」提升到「事件」。
LLM 输出按字段契约解析并做容错重试,单篇失败只留痕、不阻断整批;检索侧把 embedding 以 BLOB 存进 SQLite,用 numpy 做全量余弦检索。
架构
RSS 数据源(36氪 / IT之家 / 少数派)→ crawler.py(抓取 + 关键词过滤 + 双重去重 + 超时重试 + 熔断)→ SQLite(articles / analysis / trends)→ analyzer.py(LLM 摘要 / 情感 / 标签 / 实体)、rag.py(向量化 + numpy 余弦 Top-3 关联 + 周度趋势聚类)、events.py(关联链 → 事件实体 + 时间线)、dashboard.py(Streamlit 看板 + 对话式问答)、report.py(HTML 日报)→ mailer.py(SMTP 推送)、alert.py(负面高置信事件 → 钉钉 / 企业微信 Webhook)。存储访问全部收敛在 storage.py,便于迁移到 PostgreSQL。
数据源用 RSS 而不是硬爬
- 背景
- 资讯站点结构经常变化,硬爬需要不断维护选择器,也更容易触发反爬。
- 选择
- 统一使用 RSS(feedparser)
- 原因
- RSS 稳定、无反爬、结构规范,可以把精力留给 LLM 应用层而不是解析维护。
- 考虑过的方案
- 对每个站点写专用爬虫
- 统一走 RSS 订阅
百级数据用 numpy 全量余弦,而不是引入向量数据库
- 背景
- 库内数据量在百级,检索延迟与规模都不构成瓶颈。
- 选择
- embedding 以 BLOB 存 SQLite,用 numpy 做全量余弦检索
- 原因
- 百级数据全量余弦是毫秒级,零新增基础设施,同时预留 faiss / pgvector 演进路径。
- 考虑过的方案
- 引入 faiss / pgvector 等向量库
- embedding 存 BLOB + numpy 全量计算
不把 LLM 当确定性函数
- 背景
- 模型偶尔会返回不合规的 JSON 或越界的字段值。
- 选择
- 字段契约 + response_format=json_object + 宽容提取 / 严格校验 + 重试 2 次 + 失败留痕不阻断整批
- 原因
- 把「模型可能出错」当成常态处理,保证流水线整体可用。
每一步独立容错,宁可产出降级日报
- 背景
- 依赖多(数据源、LLM、SMTP、Webhook),全链路任何一环失败都会导致当天没有产出。
- 选择
- 半成品日报好过没有日报——每一步独立容错,失败信息以「降级说明」写进当天日报
- 原因
- 保持「每天都有产出」的可预期性,同时让失败可见。
技术栈
后端
- Python
- feedparser
- requests(超时重试 / 信源健康探测 / 熔断)
- run_daily.py 编排
AI
- OpenAI 兼容 LLM(DeepSeek)结构化输出
- bge-m3 embedding
- numpy 余弦检索
- 周度趋势聚类
前端
- Streamlit
- plotly(看板 / 对话问答 / 事件时间线)
数据库
- SQLite 三表(articles / analysis / trends)
- WAL 模式
- 事务批量写入
DevOps 与基础设施
- pytest(197 用例)
- Ruff
- Dockerfile + docker-compose
- GitHub Actions CI
- Windows 任务计划程序
基础设施
- Dockerfile + docker-compose
- 自建服务器部署的 Streamlit 看板(零 Key 演示快照)
- SMTP 邮件推送
- 钉钉 / 企业微信 Webhook
技术亮点
数据源选型用 RSS 而非硬爬
稳定、无反爬、结构规范,把精力留给 LLM 应用层。
去重粒度从「链接」提升到「事件」
URL 唯一约束(精确层)+ 标题相似度 ≥0.85 的模糊去重(事件层)双层设计。
不把 LLM 当确定性函数
字段契约 + json_object 输出 + 宽容提取 / 严格校验 + 重试 2 次 + 失败留痕不阻断整批。
技术选型匹配规模
百级数据用 numpy 全量余弦(毫秒级)+ BLOB 存 SQLite,零新增基础设施,同时预留 faiss / pgvector 演进路径。
降级与容错:半成品日报好过没有日报
每一步独立容错,失败信息以「降级说明」写进当天日报;无 Key 时看板自动降级为关键词检索。
企业级防灾加固
sent_alerts 状态表实现告警幂等防风暴、信源熔断隔离、长链拓扑剪枝防主题漂移、WAL + Checkpoint 防锁库。
难点与取舍
LLM 输出不稳定
- 问题
- 模型偶尔返回不合规 JSON 或越界字段,直接消费会导致整批分析失败。
- 做法
- 严格 JSON 字段契约 + 宽容解析 + 枚举与数值范围校验 + 指数退避重试;单篇失败只留痕,不阻断整批。
- 结果
- 单篇异常不再影响当天整体产出。
事件级去重的准确率与性能平衡
- 问题
- 标题相似度如果做全量两两比较,会随着数据增长迅速变慢。
- 做法
- 先用长度剪枝 + 字符集初筛,再用 SequenceMatcher 做阈值判定。
- 结果
- 实测重复入库率 0%。
告警风暴
- 问题
- 同类负面事件如果每条都推送,会在群里持续骚扰。
- 做法
- 只在「负面 + 置信度 ≥0.8 + 近 2 天窗口」时触发,并用 sent_alerts 持久化去重,重试不重复推送。
- 结果
- 告警幂等,失败留排障日志。
关联链的传递性漂移
- 问题
- 相关事件不断合并会把不相关的主题串成一条长链。
- 做法
- 用并查集合并 related_event 链,并用 max_size=15 的关联密度拓扑剪枝阻断长链漂移。
- 结果
- 事件聚合保持在可解释的范围内。
SQLite 并发与生命周期
- 问题
- 长期运行容易出现锁库与数据无限膨胀。
- 做法
- WAL 模式 + 批量事务写入 + TTL 级联修剪 + Checkpoint。
- 结果
- 避免锁库,数据量受控。
依赖不稳定性
- 问题
- 外部依赖(数据源、LLM、SMTP、Webhook)任意一环不可用都可能中断流程。
- 做法
- 每个模块可 dry-run;无 API Key / 无 SMTP / 无 Webhook 均能降级运行。
- 结果
- 流程不中断,缺失部分以降级说明呈现。
权衡取舍
数据源采集方式
选了 统一 RSS 订阅,而不是 为每个站点写专用爬虫 —— RSS 稳定、结构规范、无反爬,维护成本远低于选择器。
向量检索方案
选了 embedding 存 BLOB + numpy 全量余弦,而不是 引入 faiss / pgvector 等向量数据库 —— 百级数据量下全量余弦已是毫秒级,不值得为此新增基础设施。
代价:数据规模显著增长时需要切换到向量库(已预留演进路径)。
故障处理策略
选了 每步独立容错 + 降级说明写进日报,而不是 任一环节失败即整条流水线终止 —— 保持每天都有产出的可预期性,同时让缺失部分可见。
结果
测试:pytest 197 个用例全绿(本次实测收集 197、执行 197 passed),覆盖告警 / 分析 / 配置 / 采集 / 事件 / 日志 / 邮件 / RAG / 日报 / 存储十个模块。
采集与去重:3 个 RSS 源单轮抓取约 60 条,关键词命中约 12 条,重复入库率 0%(增量二轮 0 新增)。
数据规模:主库 34 条文章 / 24 条已分析;演示快照 24 篇全分析 / 3 条趋势。
性能与成本:日报生成到 HTML 落盘全流程 < 30 秒(无 LLM 调用时);百级数据 numpy 余弦检索为毫秒级;单次 LLM 分析上限 20 篇,token 用量入库可追溯。
线上 Demo:自建服务器部署的 Streamlit 看板 https://intel.myiskg.com/ (零 Key 演示快照,自 2026-09-24 起启用 HTTPS),可查看指标卡、情感趋势、情报列表与带引用的对话问答。
交付:已上线零 Key 演示站点(看板 + 对话问答),并提供生产 Docker 镜像与编排。
收获
去重粒度要和业务对齐:只按 URL 去重收敛不到「事件」,而事件级去重需要先做剪枝再比较,否则数据一涨就变慢。
依赖多的系统要有降级策略:「半成品日报好过没有日报」比追求全链路成功更符合实际使用。
技术选型要匹配数据规模:百级数据用 numpy + SQLite 已经够快,过早引入向量库只会增加运维负担。
截图
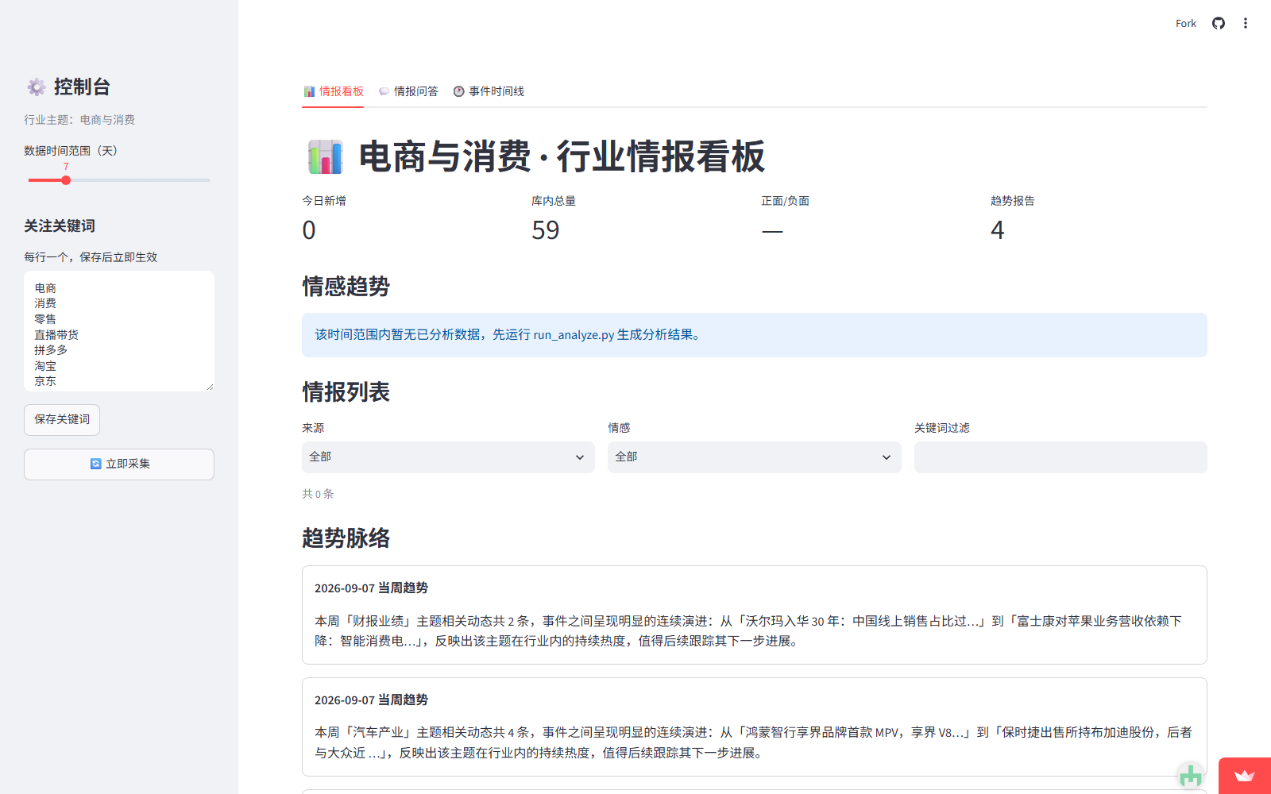
可视化看板:指标卡 / 情感趋势 / 情报列表 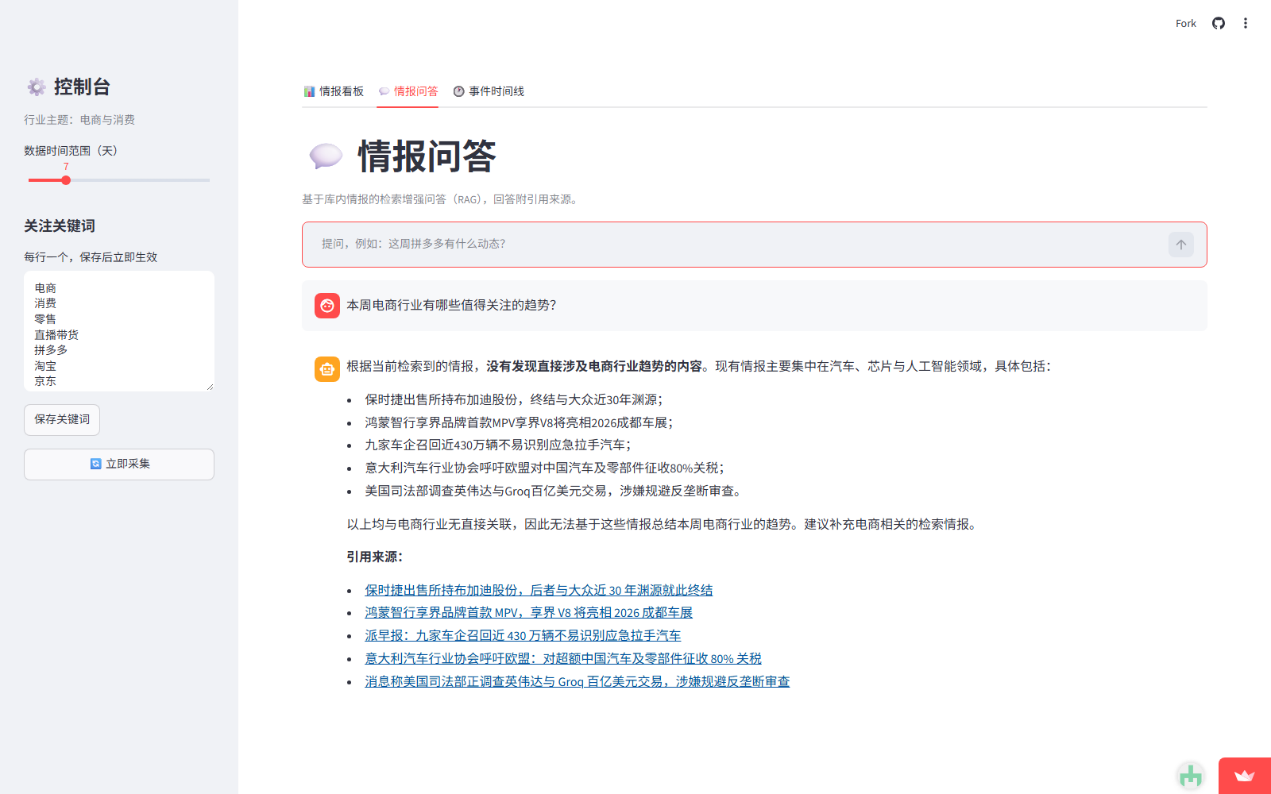
对话式问答:带引用来源的行业问题回答